そのバックテスト、シャッフルに勝てますか — 実力と偶然を分ける15行のコード
Ember 編集部 ・ 2026-07-21 ・ 約6分 ・ finance
本記事は情報提供・教育を目的としたものであり、特定の金融商品の取得・売買を推奨する投資助言ではありません。投資判断はご自身の責任で行ってください。
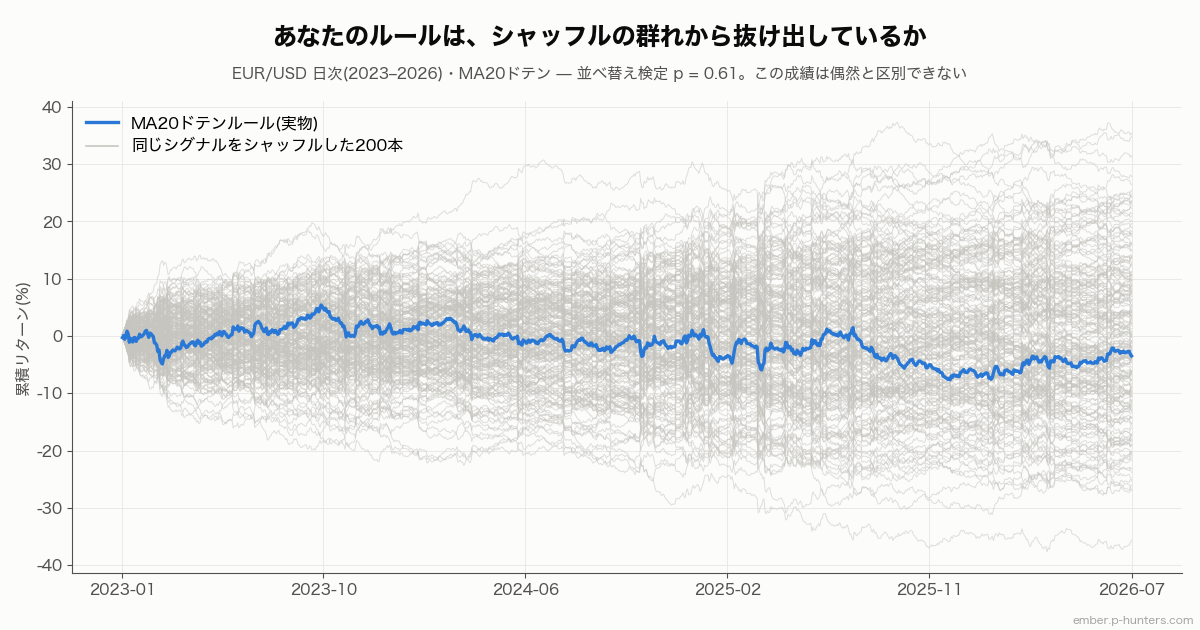
バックテストで年率+10%の成績が出たとします。おめでとうございます。ところで — 実力ゼロのルールは、同じデータで偶然どのくらいの成績を出すのでしょうか 。 この問いに数字で答えられないかぎり、+10%という数字は評価不能です。誤差棒のない測定値と同じで、大きいのか小さいのかすら言えません。そして答える方法は、誰でも手元で実行できる15行のコードです。 上の図は、EUR/USD の日次データ(2023〜2026年、ECB参照レート)に古典的な「20日移動平均ドテン」(終値がMA20の上なら買い持ち、下なら売り持ち)を適用した実物の損益曲線(青)と、 同じシグナル列の日付をシャッフルして 値動きに当てた200本(灰色)です。シャッフルした時点でシグナルと相場の対応は完全に破壊されているので、灰色の200本は正真正銘「実力ゼロ」の成績分布です。 青い線は、群れのど真ん中にいます。第1回・第2回で「目視の検証は信用できない」「検証は仮説を殺す道具」と話してきました。今回はその道具の実物を配ります。
1. バックテストとは「サンプル1個の統計的推論」である デビッド・アロンソン『テクニカル分析の迷信』の中核的な指摘は、拍子抜けするほど単純です。 バックテストをする人は、気づいていようがいまいが統計的推論をしている 。 あなたが本当に知りたいのは「過去3年でいくら儲かったか」ではありません。「このルールは これから 儲かるか」— つまり、観測不能な母集団(ルールの真の期待リターン)について、手元のサンプル1個(バックテスト成績)から推論したいわけです。これは統計学が150年かけて作法を整備してきた問題そのものです。そして作法の第一歩は、いつも同じです。 帰無仮説 $H 0$ : このルールに予測力はない。真の期待リターンは 0 である。 「まず疑う」のは意地悪ではなく、論理的な必然です。「予測力がある」という仮説は無限の形がありえて反証できませんが、「予測力ゼロ」はただ一点の主張なので、反証できます。だから検証の問いはこう立てます — 予測力ゼロのルールが、偶然でこの成績を出す確率はいくらか 。 ちなみにFXはこの枠組みと相性が抜群です。株式には長期上昇ドリフトがあるため「買い持ちに近いルールはそれだけで儲かって見える」補正(トレンド除去)が必要ですが、主要通貨ペアの為替レート自体には恒常的なドリフトがほぼありません。「期待リターン0」という帰無仮説が、補正なしでほぼそのまま成立します(ただしスワップ金利差を含めるなら話は別で、これは第5回の主題です)。 2. 帰無分布をシャッフルで作る — モンテカルロ並べ替え検定 「偶然ならどのくらい出るか」の分布(帰無分布)は、理論式ではなくシミュレーションで作るのが現代の標準です。手順はこうです。 1. ルールのシグナル列(+1/−1 の並び)と、日次リターン列を用意する 2. シグナル列の 順番をランダムに並べ替える (シグナルの統計的性質 — 買いと売りの比率、回数 — はそのまま保存される) 3. 並べ替えたシグナル × リターンで成績を計算する 4. これを2000回繰り返す → 「実力ゼロ」の成績分布が得られる 5. 実物の成績が、この分布のどこに位置するかを見る アロンソンの共同研究者T・マスターズが考案し、書籍で公開されたモンテカルロ・パーミュテーション法そのものです。2006年当時、類似手法(ホワイトのリアリティチェック)は特許で保護され、商用ソフトを買うしかありませんでした。2026年のいま、必要なのは numpy だけです。 これだけです。 sig を1日シフトしてルックアヘッドを防ぐこと(「アルファ以前」第1回参照)だけ忘れないでください。 3. 実演 — MA20ドテンをEUR/USDで裁く 冒頭のMA20ドテンに、この検定を実際にかけた結果がこちらです。 実物の成績: 年率 −1.0% (2023〜2026年、コスト控除前) 並べ替え2000回の帰無分布: 年率 ±5% 程度は日常的に、±10% も珍しくなく出る p値 = 0.61 — 実力ゼロのルールの61%が、実物と同等以上の成績を出す つまりこの期間のEUR/USDにおいて、MA20ドテンの成績は偶然と まったく 区別がつきません。そもそもマイナスなので当然に見えますが、注目してほしいのは帰無分布の幅のほうです。 実力ゼロでも、3年半の日次データなら年率+10%前後の成績が普通に「偶然で」出る 。あなたがどこかで見た「年率8%の優位性が確認されたインジケーター設定」は、この分布のどこにいたでしょうか。 なお、これはMA20という特定の設定の、この期間・このペアでの結果です。「移動平均は使えない」という一般命題を証明したわけではありません(検証は殺すことしかできない、を思い出してください)。トレンドフォローが機能する条件については第5回で戻ってきます。 4. p値の読み方 — 3つの注意 この検定を配るにあたって、p値の誤読への注意書きを添えます。2016年に米国統計学会が公式声明を出すほど、専門家でも間違え続けてきた点です。 注意1: p値は「手法が本物である確率」ではない 。p = 0.61 は「帰無仮説(実力ゼロ)を仮定したとき、この成績以上が出る確率」です。$P(\text{データ}\mid H 0)$ であって $P(H 0\mid\text{データ})$ ではありません。この2つを繋ぐには事前確率が要ります — そして「世に出回るルール候補のほとんどは実力ゼロ」という事前分布の下では、p = 0.05 を切った手法ですら、その大半が偽物です。小さいp値は「合格」ではなく「まだ殺せなかった」にすぎません。 注意2: 0.05は魔法の数字ではない 。p = 0.049 と 0.051 の間に本質的な違いはありません。閾値で二分するより、帰無分布の中での位置(冒頭のスパゲッティ図)を眺めるほうが、意思決定の質は上がります。 注意3: この検定が守れるのは「1回だけ試した人」だけ 。パラメータを20通り試して一番良いものにこの検定をかけると、p値は壊れます。MA20がダメならMA50、ダメならMA200 — その探索の各ステップが、偶然に「当たり」を引くチャンスを増やしているからです。これが次回の主題、 データマイニング・バイアス で、個人のバックテスト文化における最大の毒です。 技術的な補足をひとつだけ: 単純なシャッフルはリターンの自己相関やボラティリティの塊(クラスタリング)を壊すため、厳密にやるならブロック単位で並べ替える改良版(ブロック・ブートストラップ系)を使います。シャープレシオ側から同じ問題に迫る道具立ては「アルファ以前」第3回にまとまっています。 5. 今日からの使い方 手順は3つです。 1. 自分のルールを プログラムに書ける形 にする(書けないなら第2回に戻る) 2. 上の15行にかけて、p値と、スパゲッティ図の中の自分の位置を見る 3. p値が小さくても喜ばない。 「何回試した末のルールか」を数えて 、次回の記事に進む シャッフルの群れから抜け出せないルールに、リスクを載せる理由はありません。そして群れから抜け出して見えるルールの多くも、実は「200回試したうちの1位」なのです — それが偶然の最大値とどう区別できないかを、次回、コイン投げ200個で実演します。 連載「迷信の解剖」 (全5回) — デビッド・アロンソン『テクニカル分析の迷信』(パンローリング)を、20年後の視点とFXの実データで再検証するシリーズです。 第1回: あなたはコイン投げとドル円を見分けられない 第2回: 未来が決まってから、パターンの名前が決まる 第3回(本稿): そのバックテスト、シャッフルに勝てますか 第4回: 実力ゼロの戦略200個から「聖杯」が生まれる 第5回: それでも為替に歪みが残る理由