実力ゼロの戦略200個から「聖杯」が生まれる — データマイニング・バイアス、個人トレーダー最大の毒
Ember 編集部 ・ 2026-07-21 ・ 約7分 ・ finance
本記事は情報提供・教育を目的としたものであり、特定の金融商品の取得・売買を推奨する投資助言ではありません。投資判断はご自身の責任で行ってください。
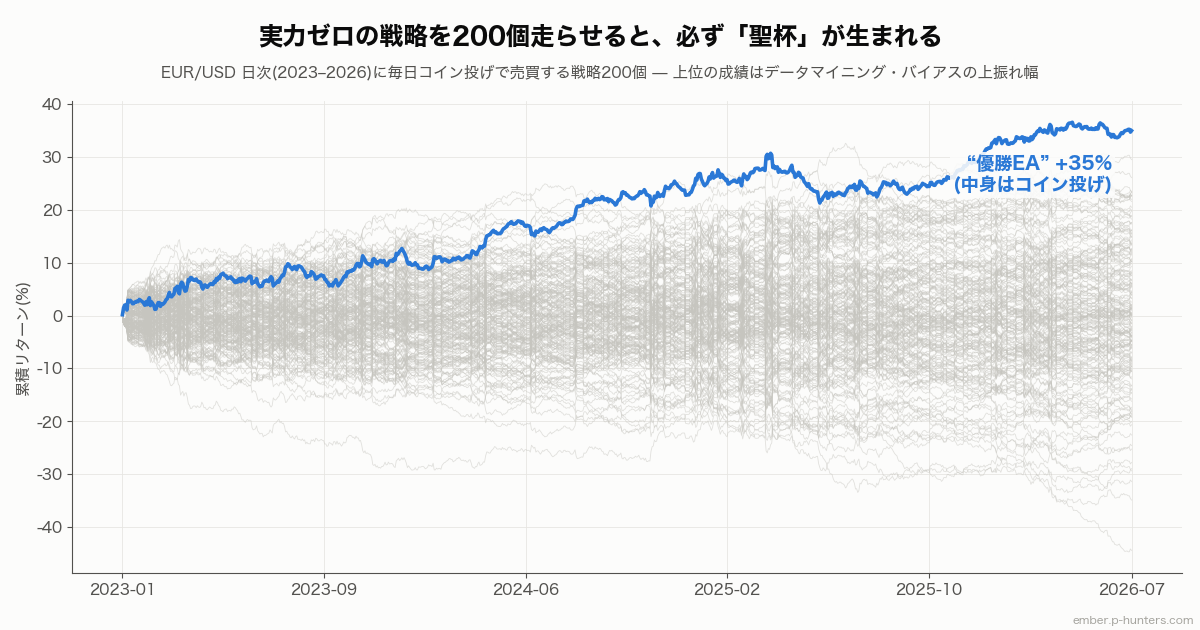
コイン投げで売買する戦略を200個作って、EUR/USD の3年半(2023〜2026年、日次)で走らせました。毎日コインを投げて、表ならロング、裏ならショート。定義により、全戦略の真の実力は完全にゼロです。 結果がこちらです。 優勝者は +35% 。ほぼ一直線の右肩上がり、目立ったドローダウンなし。この損益曲線を「3年半のフォワード実績」として見せられて、疑える人がどれだけいるでしょうか。中身はコイン投げです。 種明かしはシンプルで、 200個も走らせたから です。1個1個は偶然に上下するだけでも、200個の中の最大値は、ほぼ確実に立派な成績になります。そして — ここが本題ですが — パラメータ最適化も、EAランキングも、手法の乗り換え遍歴も、構造はこれと完全に同じ です。
1. 最も見過ごされている統計量 —「N個の中の最大値」 第3回では、ルール1個の成績を偶然と比べる方法をやりました。今回の主題は、その検定が 壊れる 条件です。 あなたが MT5 のオプティマイザでパラメータを500通り試し、一番良かった設定を採用したとします。このとき、あなたが見ている「+35%」という数字は、ルール1個の成績ではありません。 「500個の成績の最大値」という、まったく別の統計量 です。 ルール1個の成績: 偶然だけなら0を中心に上下にばらつく 500個の最大値 : 偶然だけでも、ほぼ確実に大きなプラスになる 最大値を「1個の成績」用の物差し(普通のバックテスト評価、第3回の検定を含む)で測ると、系統的に、そして大幅に、実力を過大評価します。この過大評価分がデータマイニング・バイアスです。デビッド・アロンソン『テクニカル分析の迷信』が1章を割いて実験する、本書のハイライトです。彼が人工ルールで示した規模感は強烈で、たとえば2年分のデータで50個試すだけで、実力ゼロの「最優秀」は年率+30%超に見える — 私たちのコイン投げ200個の実験と符合します。 重要な注意をひとつ。 データマイニング(たくさん試して選ぶ)自体は、悪ではありません 。むしろ、観測成績が最も良いものを選ぶのは合理的な戦略です。壊れているのは選び方ではなく、 選んだ後にその成績数字をそのまま将来の期待値だと読む ことです。選択に使った数字は、選択によって汚染されています。 2. 「フォワードで死ぬ」のは市場が変わったからではない EA界隈で最もよく聞く弁明は「バックテストは良かったが、相場の地合いが変わった」です。もちろん市場は変わります。しかし、選抜後の成績悪化を説明するのに、市場の変化は 必要ありません 。 上の図は同じコイン投げ200個の実験で、 前半3分の2の成績だけで 優勝者を選び、その後を追ったものです。選抜期間+27%、その後−6%。市場は何も変わっていません(そもそもコインは市場を見ていません)。変わったのは1つだけ — 選抜が終わった ことです。 選抜期間の+27%は「実力+幸運」の合計でした。実力はゼロなので、全部幸運です。そして幸運は選抜期間に消費済みで、翌日からは補充されません。期待値ゼロに戻るだけです。これが、バックテストで選ばれた戦略が「選ばれた直後から」平凡になる、あの普遍的な現象のいちばん単純な説明です。アロンソンはこの説明がオッカムの剃刀に適うことを丁寧に論じています — 「検証が終わった瞬間に毎回都合よく市場が変わる」という説明より、はるかに少ない仮定で全事例を説明できるからです。 Myfxbook や MQL5 マーケットのランキング上位から EA を選ぶ行為も、まったく同じ構造です。数千個の EA(それぞれ作者がさらに何百通りも最適化済み)の成績上位を眺めることは、数十万回のコイン投げの最大値を眺めることです。 ランキングから選ぶという行為そのものが、あなたを巨大なデータマイニングの最終工程に組み込みます 。購入者は自分が検証していないので、バイアスだけを純粋に受け取ることになります。 3. バイアスの大きさを決めるもの — 毒の用量反応曲線 このバイアスは定量できます。試行数 $N$ と検証期間を振って、実力ゼロの「最優秀」の期待成績をシミュレーションした結果がこちらです(EUR/USD の実測日次ボラティリティを使用)。 読み取れることは3つです。 1. バイアスは試行数の対数でほぼ直線的に育つ 。極値理論の教える通り、最大値の期待は $\sigma\sqrt{2\ln N}$ のオーダーで伸びます。2個試せば見かけの成績はすでに水増しされ、1024個なら1年検証で 年率+20%超 が「実力ゼロで」出ます 2. 最強の解毒剤は検証期間(観測数) 。同じ1024個でも、検証期間を1年→16年にするとバイアスは4分の1になります。$\sigma \propto 1/\sqrt{T}$ だからです 3. 最悪の組み合わせは「短い期間 × 大量の試行」 。直近1〜2年のデータでオプティマイザを回す、という最も一般的な使い方が、ちょうどこの最悪の象限にあります もうひとつ実務的な救いも書いておきます。試行数 $N$ は「パラメータの組み合わせ総数」ではなく 実効的な多様性 で数えます。MA期間20と21のルールはほぼ同じシグナルを出すので、2個ではなく実質1個です。500通りの最適化が実効50個相当ということもよくあります。闇雲に絶望する必要はなく、「自分は実効何個試したのか」を意識すること自体が防御になります。 実験の再現コードはこれだけです。手元のペア・期間で「偶然の優勝者」がどんな顔をしているか、一度見ておくことを勧めます。 4. 解毒プロトコル — 2006年の処方と2026年の処方 アロンソンが挙げた対策は、20年経ったいまも骨格として有効です。現代の道具で更新しつつまとめます。 処方1: アウトオブサンプル(OOS)を本当に1回だけ使う 。データを分割し、選抜に使っていない期間で最終評価する。これだけでOOS成績は不偏になります。ただし鉄の掟がひとつ — OOSの新鮮さは1回で失効する 。OOSの結果を見てパラメータを直したら、そこはもうOOSではありません。フォワードテストも同じで、「フォワードが悪かったので調整して再フォワード」を繰り返した時点で、あなたはフォワード期間を選抜期間に変えています。 処方2: ウォークフォワード検証 。「過去n年で選抜→次のm カ月で評価」を窓をずらして繰り返す方式。OOS評価を何度も(毎回新鮮な形で)行え、非定常な市場への追従力も同時に測れます。分割の恣意性という弱点は残りますが、個人が実行できる検証としては現在も最良に近い選択です。 処方3: 試行数を記録し、成績を割り引く 。最も軽視され、最も効く習慣です。研究ノートに「この戦略ファミリーで試した設定の数」を記録し続ける。そして最終候補の成績を、第3回の検定の 多重比較版 で評価します。シャッフル検定の拡張は素直で、各シャッフルで「N個全部を計算して最大値を取る」ことを繰り返し、 最大値の帰無分布 と比べるだけです(アロンソンの本ではホワイトのリアリティチェック、マスターズのモンテカルロ・パーミュテーションとして登場します。当時は特許と商用ソフトの世界でしたが、いまは全部無料で書けます)。その後の20年でこの系譜は、多重試行を織り込んでシャープレシオを割り引く Deflated Sharpe Ratio や、バックテスト過剰適合確率(PBO)を直接推定する手法(López de Prado ら)へと発展しました。深追いしたい方は「アルファ以前」第3回へ。 処方4: 事前に理論を持つ 。探索空間を「儲かりそうな数式全部」から「機能する理由を説明できる仮説」に絞ることは、$N$ を桁で減らします。なぜその歪みが存在し、誰がその代金を払っているのか — この問いに答えられる戦略は、データマイニングの毒に対して最初から耐性があります。そしてこの問いこそ、最終回の主題です。 5. まとめ — 数字より先に、数を聞け 誰かの(自分の)輝かしいバックテストを見たら、成績の数字より先に、こう問うてください。 「それは、何個試したうちの1位ですか。」 この一問だけで、世の中の「聖杯」の大半は、コイン投げ200個の優勝者と区別がつかなくなります。区別する方法は存在します — OOSの規律、ウォークフォワード、試行数を織り込んだ検定。どれも地味で、どれも成績を悪く見せる方向にしか働きません。だからこそ、それを自分に課している人と、課していない人の「+35%」は、同じ数字でも別のものなのです。 連載「迷信の解剖」 (全5回) — デビッド・アロンソン『テクニカル分析の迷信』(パンローリング)を、20年後の視点とFXの実データで再検証するシリーズです。 第1回: あなたはコイン投げとドル円を見分けられない 第2回: 未来が決まってから、パターンの名前が決まる 第3回: そのバックテスト、シャッフルに勝てますか 第4回(本稿): 実力ゼロの戦略200個から「聖杯」が生まれる 第5回: それでも為替に歪みが残る理由