世界最高峰の「ロボットサッカー」論文を読む — DeepMind OP3研究のレシピ【アヒルで学ぶフィジカルAI 番外編2】
Ember 編集部 ・ 2026-08-30 ・ 約5分 ・ robotics
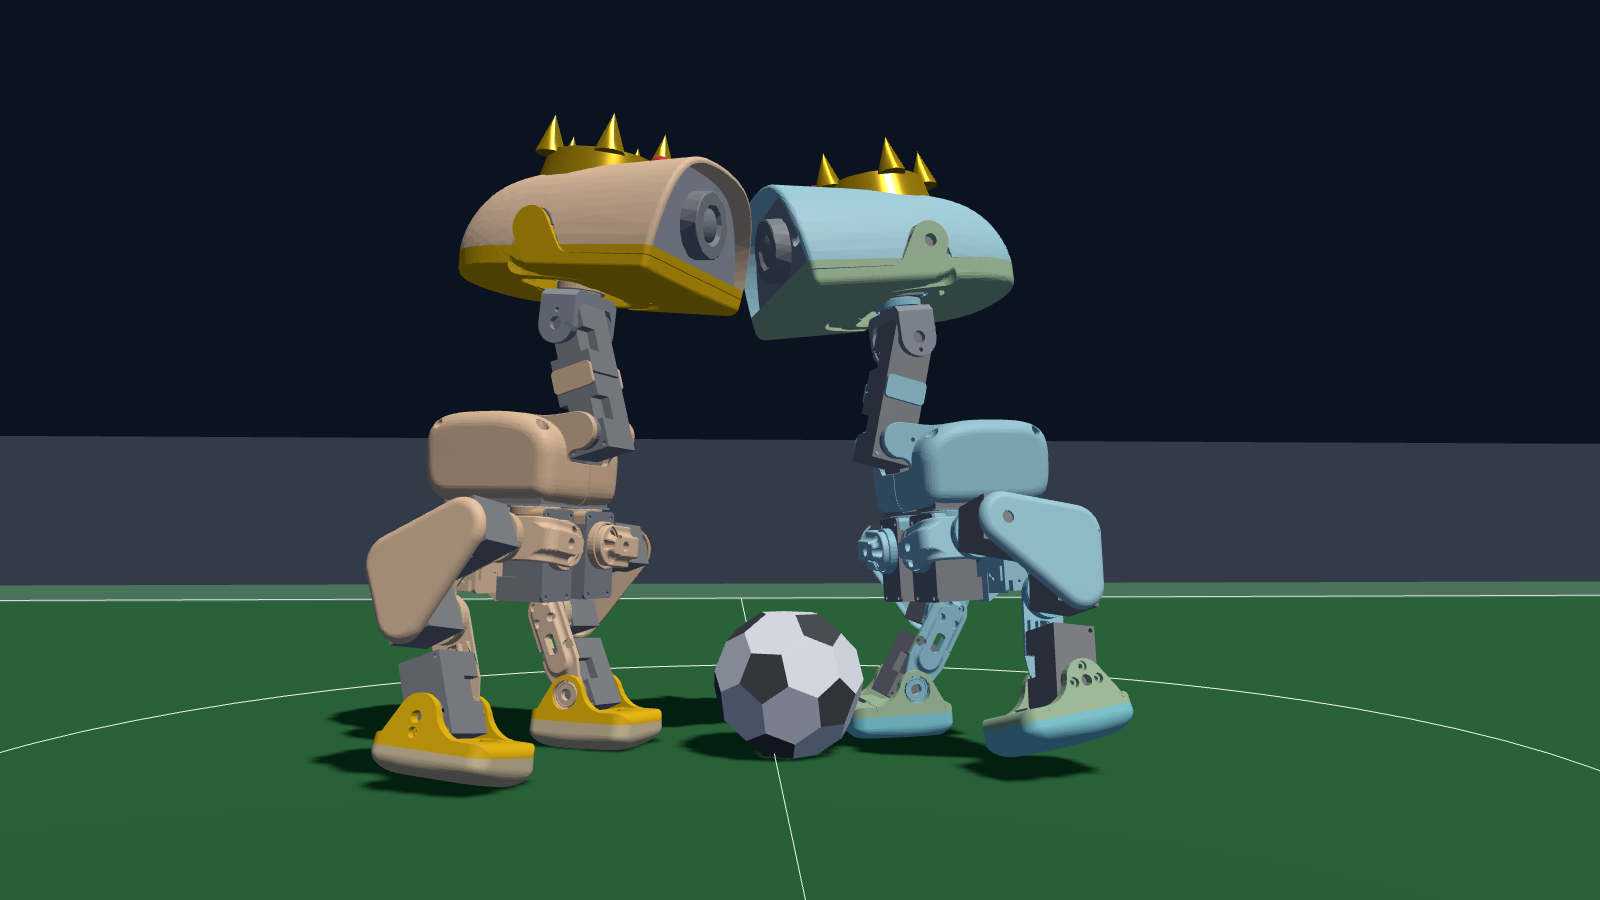
本連載のFUTSAL DUCKSプロジェクトには、設計図として崇めている論文が1本あります。DeepMindのHaarnojaらによる<strong 「Learning Agile Soccer Skills for a Bipedal Robot with Deep Reinforcement Learning」</strong (Science Robotics, 2024)。身長51cmの二足歩行ロボットに1対1のサッカーを教え、シミュレーションで学んだ技を 実機にそのまま転移 させた研究です。 転んだら即座に起き上がる。相手とゴールの間に体を入れる。フェイントをかける。これらは誰もプログラムしていません。 全部、報酬から勝手に生えてきた のです。 今回は番外編として、この論文を「レシピ」として読み解きます。読み終わる頃には、世界最高峰の研究と、あなたのブラウザで動くアヒルたちが、同じ道を歩いていることが見えるはずです。
材料: 51cmのロボットと、たった1つの相手 まず登場人物を確認しましょう。ロボットはRobotis社のOP3。 身長51cm、体重3.5kg、モーター20個 の市販ヒューマノイドです。本連載のmicroduck(25cm・800g・サーボ15個)の、ちょうど兄貴分にあたる体格です。 競技は1対1のサッカー。ピッチは5m×4m。ルールは単純で、相手ゴールにボールを入れたら勝ち。この「単純さ」が重要です。研究の主役は複雑なルールではなく、 「歩く・転ぶ・起きる・蹴る・駆け引きする」という身体と戦術の統合 だからです。 レシピは2段階 — まず技を仕込み、次に試合で混ぜる この論文の核心は、料理の下ごしらえに似た 2段階の学習 にあります。 第1段階: スキルの単体学習。 2つの「先生ポリシー」を別々に訓練します。1つ目は 起き上がりポリシー — 地面に転がった状態から立ち上がる技。2つ目は サッカーポリシー — ゴールを狙う技。面白いのは後者の対戦相手で、なんと「訓練していない、ほぼ即座に転ぶポリシー」を相手にします。まずは弱い相手で成功体験を積ませるのです。 第2段階: 蒸留とセルフプレイ。 2人の先生の技を、 蒸留 (distillation)という手法で1つの方策に混ぜ合わせます。立っているときはサッカーの先生に、転んでいるときは起き上がりの先生に似るよう誘導しながら、1対1の実戦で鍛え直す。そして相手には 過去の自分のスナップショット を使います — これが セルフプレイ です。 学習アルゴリズムはDMPO(分布型MPO)という強化学習の一種ですが、本質は連載本編で扱ったPPOと同じ「報酬が増える方向に方策を少しずつ動かす」仕組みです。 道具箱: セルフプレイ — 自分の過去と戦う 今回の新しい道具は セルフプレイ です。 対戦ゲームの強化学習には固有の難問があります。相手が固定だと、その相手「だけ」に勝つ攻略法に過剰適応してしまう。かといって常に最新の自分と戦わせると、ジャンケンのような 堂々巡り が起きます — グーに勝つパーを覚え、パーに勝つチョキを覚え、チョキに勝つグーを覚え……強くなった気がして、実は円を描いているだけ。 論文の処方箋はシンプルです。 相手を「過去の自分のスナップショット群」から一様ランダムに選ぶ。 歴代の自分たち全員にまんべんなく勝てなければならないので、円を描いて逃げる余地がなくなる。特定の相手への攻略法ではなく、 汎用的な強さ だけが生き残ります。 FUTSAL DUCKSでも今、まったく同じ仕組みが回っています。アヒルの戦術ネットは30分ごとに自分のコピーを「対戦相手プール」に登録し、エピソードのたびに歴代の自分から相手を引き当てて戦っています。 sim2realの秘密 — わざと意地悪な世界で育てる シミュレーションで覚えた技を実機で動かす(sim2real)ために、論文は連載第7回で紹介した ドメインランダマイゼーション を徹底しています。床の摩擦を0.5〜1.0でばらつかせ、関節の取り付け角を±2.9°ずらし、観測に10〜50msの遅延を混ぜ、最大0.5kgの重りをランダムに背負わせる。 そして一番効いたのが、 訓練中にロボットを突き倒すこと 。ランダムな衝撃を加え続けると、方策は「押されても立て直す」術を織り込んで育ちます。過保護に育てた方策は現実の小さな凸凹で転びますが、意地悪な世界で育った方策は現実が優しく見える、というわけです。 結果 — 手書きプログラムへの圧勝 学習した方策を、人間が丁寧に書いたスクリプト制御と比べた数字が痛快です。 歩行速度: 181%速い 旋回速度: 302%速い 起き上がり: 63%短時間 キック: 34%速い さらに誰も教えていない行動が創発しました。攻める相手と自陣ゴールの間に体を割り込ませる ディフェンス位置取り 。足の角で軸を作ってクルッと回る ピボットターン 。守備では歩幅を刻み、攻撃では大股になる 状況適応 。報酬は「ゴールしたら加点」を軸にした単純なものなのに、勝つために必要な振る舞いが物理と対戦の圧力から絞り出されてくる — 強化学習の一番美しい瞬間です。 告白: 世界最高峰も「神の視点」だった ここで、正直な種明かしを1つ。この実験の実機ロボットは、ボールと相手の位置を 自分のカメラで見ていません 。天井の モーションキャプチャシステム が全員の座標を計測し、無線でロボットに送っていました。つまり実機ですら「神の視点」なのです。 これは手抜きではなく、 問題を切り分ける科学の作法 です。「戦術を学べるか」と「自分の目で世界を知覚できるか」は別の難問で、一度に両方を解こうとすると、どちらでつまずいたのか分からなくなる。まず神の視点で戦術を解き、知覚は次の研究で(実際、同グループはその後、車輪ロボットでの視覚版に取り組んでいます)。 FUTSAL DUCKSのアヒルたちも現在は同じ段階にいます。シミュレータから直接ボールと敵の座標をもらう「特権観測」で戦術を学び、その次の段階として「頭のカメラの視野に入っているときだけ見える」制約を入れる計画です。世界最高峰と同じ順番で、同じ理由で。 アヒルたちとの対応表 OP3論文 FUTSAL DUCKS 51cm・20モーターのOP3 25cm・サーボ15個のmicroduck 起き上がり+サッカーの先生を蒸留 公式歩行ポリシーを凍結して土台に、戦術層を学習 弱い相手→セルフプレイ ボール追跡ボット→過去世代プール 突き倒しながら訓練 コーナーの強力バネに吹き飛ばされながら訓練(近日) 実機はモーションキャプチャ ブラウザ内シミュレータの特権観測 規模も予算も桁違いですが、 レシピの骨格は同一 です。これが論文を読む醍醐味で、一流の研究は「真似できる形」で書かれています。 観察課題 FUTSAL DUCKSのロビーで「🧠 RLブレイン」をONにして、ソロで遊んでみてください。RL訓練された敵アタッカーがボールに寄ってくる動きと、それ以外のヒューリスティック(手書き)ボットの動きを見比べて、 どちらがどちらか当てられるか 試してみましょう。当てられたなら、あなたはもう「学習した動き」と「書かれた動き」の質感の違いを見分ける目を持っています。 原論文はarXivで無料公開されています(2304.13653)。英語ですが、図と動画だけでも一見の価値ありです。 本連載の過去回はアヒルで学ぶフィジカルAIから。