歩き方は教えていない、育てた — 強化学習の直感【アヒルで学ぶフィジカルAI #5】
Ember 編集部 ・ 2026-08-28 ・ 約4分 ・ robotics
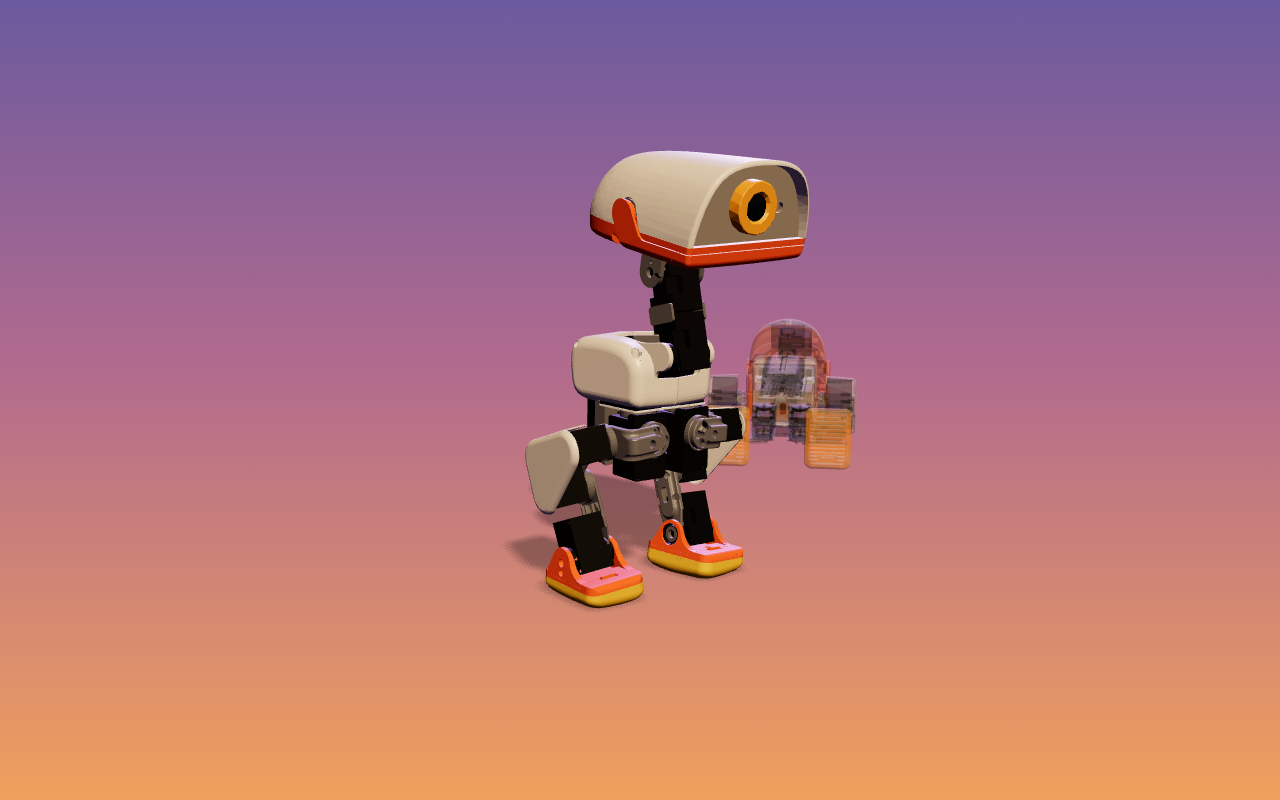
前回、アヒルの脳(ポリシー)は「観測61個 → 関節指令14個」の変換だと説明しました。今回はその変換の中身と、それを 誰がどうやって作ったのか の話です。 まず素朴な疑問から。歩行プログラムなんて、人間が普通に書けばいいのではないでしょうか。「右足を上げる、前に出す、着地、次は左足」と。 実際、昔のロボットはそう作られていましたし、今もその系譜の制御は現役です。しかし14個の関節を持つ二足歩行で、押されても、ボールにつまずいても、ローラースケートを履かされても転ばない動きを人手のルールで書き切るのは、絶望的に難しい。理由は単純で、 「正解の関節角度の時系列」を人間自身が知らない からです。あなたは歩けますが、歩行中の股関節の角度変化を数式で書けと言われたら書けないでしょう。体が知っていることを、言葉にできない。 こういう「正解は説明できないが、結果の良し悪しは判定できる」問題のための機械学習が、<strong 強化学習(Reinforcement Learning, RL)</strong です。
道具箱① 報酬 — 「どう動け」ではなく「何が良いか」だけを言う 強化学習の枠組みは3行で書けます。 1. ポリシー(最初はデタラメ)が観測を受け取り、行動を出す 2. シミュレータが物理法則どおりに結果を計算する 3. 結果に<strong 点数(報酬)</strong をつけ、点が上がるようにポリシーを少し直す。これを延々と繰り返す 人間が設計するのは、動き方ではなく 採点基準 だけです。歩行の場合、採点表はおおよそこんな中身になります。 初日のアヒルは、関節をランダムにばたつかせて即転倒します。でも何百万回も試すうち、「膝をこう曲げた回はマシだった」という偶然の成功が点数に刻まれ、少しずつ「まぐれ」が「技」に変わっていく。<strong 転倒は失敗ではなく、教材です。</strong マイナス報酬という形で、何が駄目かを教えてくれる。 ここで第1回の伏線がひとつ回収されます。シミュレータの中なら、何百万回転んでもタダ。現実のロボットで同じ練習をしたら、1日目に部品箱が空になります。 強化学習と物理シミュレータはセットで初めて実用になる ——フィジカルAIの現在の型です。 道具箱② ポリシーの正体 — 0.8MBの脳 ポリシーの実体は、ニューラルネットワークです。といっても、ChatGPTのような巨大なものではありません。 ゲームが読み込んでいる歩行ポリシーのファイルは 約0.8MB 。中身のパラメータ(学習で調整される数値)は 約20万個 です。ChatGPT級のモデルが数千億個であることを考えると、100万分の1以下。スマホの写真1枚より小さい「脳」が、二足歩行という離れ業をこなしています。 構造も素朴で、61個の入力が数層の中間層を通って14個の出力になる、教科書どおりの多層ニューラルネットワークです。 歩行の賢さは、ネットワークの大きさではなく、訓練の量と採点基準の質に宿る ——これがロボット学習の面白いところです。 学習アルゴリズム(採点結果からパラメータをどう直すかの手順)には、PPOという手法の系統が使われます。名前は今は暗記不要です。「点数が上がる方向に、少しずつ、壊れない歩幅で直す」工夫だと思ってください。 道具箱③ 並列世界 — 練習量で殴る もうひとつの主役が、練習量です。 このアヒルの訓練では、GPUの上で 数千体のアヒルを同時に シミュレートします。数千の平行世界で、少しずつ違う失敗と成功が同時に起き、その全部が1つのポリシーの改善に流れ込む。現実の時間で数時間〜数日回せば、1体のロボットが何年かけても積めない練習量になります。 そして訓練中、コマンド(前回やった「注文書」)は ランダムに変え続けます 。前進しろ、止まれ、その場で旋回しろ、斜めに歩け——。あらゆる注文に応えた回だけ点がもらえるので、ポリシーは自然と「注文どおりに動ける汎用の歩き」を身につけます。あなたがWASDでアヒルを自在に操れるのは、訓練時にこの「注文の乱れ打ち」を浴びたおかげです。 「育てた」という言葉の意味 ここまでを一枚にまとめます。 だから冒頭のゲームの歩き方は、誰のアニメーションでもありません。膝の曲げ方も、腕——ではなく首の振り方も、静止時の細かな足踏みも、採点基準と物理法則の間から 創発 したものです。よく見ると、このアヒルの歩き方には設計者の意図を超えた「癖」があります。それは教えられたものではなく、育った結果です。 念のため付け加えると、この歩行ポリシーを訓練したのは筆者ではなく、ロボットの開発元(Pollen Robotics)が公開している成果物です。私たちのゲームはそれをそのまま借りています。 世界レベルの訓練済みポリシーが、誰でも無料でダウンロードできる ——これも今この分野に入る人の追い風です。 観察課題 1. アヒルの 静止 を見てください。完全には止まらず、細かく足踏みや重心の揺り戻しを続けています。これは「静止」という注文に対してポリシーが見つけた解が、静的なポーズではなく 動的なバランス取り だったということ。人間の直立も実は同じで、静止して見えて筋肉は微調整を続けています。 2. アヒルを 壁やボールに軽くぶつけて みてください。よろけて、持ち直す。この「持ち直し」の動きはどの採点項目から生まれたか考えてみてください(ヒント: 転倒の大減点)。乱れからの回復は、明示的に教えられたのではなく、転びたくない一心で獲得された技能です。 3. 第1回の宿題で見た キック時の動きの質の変化 を思い出してください。キックは歩行とは採点基準が違う(ボールを遠くへ飛ばすと加点)ので、 別の訓練で育てた別のポリシー になっています。1つの万能な脳ではなく、専門家の脳を切り替える——この設計は第7回で正面から扱います。 次回はエンジニアリングの回です。Pythonの訓練環境で育った20万パラメータの脳を、どうやってブラウザ(そして実機)に引っ越しさせ、毎秒50回×8羽ぶん動かしているのか。キーワードは ONNX と リアルタイム推論 です。